
公開日: 2026-11-16 · VWU.AI
都市映像AIの新展開:イベントデータセットの証拠とプライバシーをどう守るか
映像イベントのアノテーションを時間区間、観察可能な証拠、判定不能の状態、レビュー記録に結び付ける方法を、車内データの検収例とともに解説します。
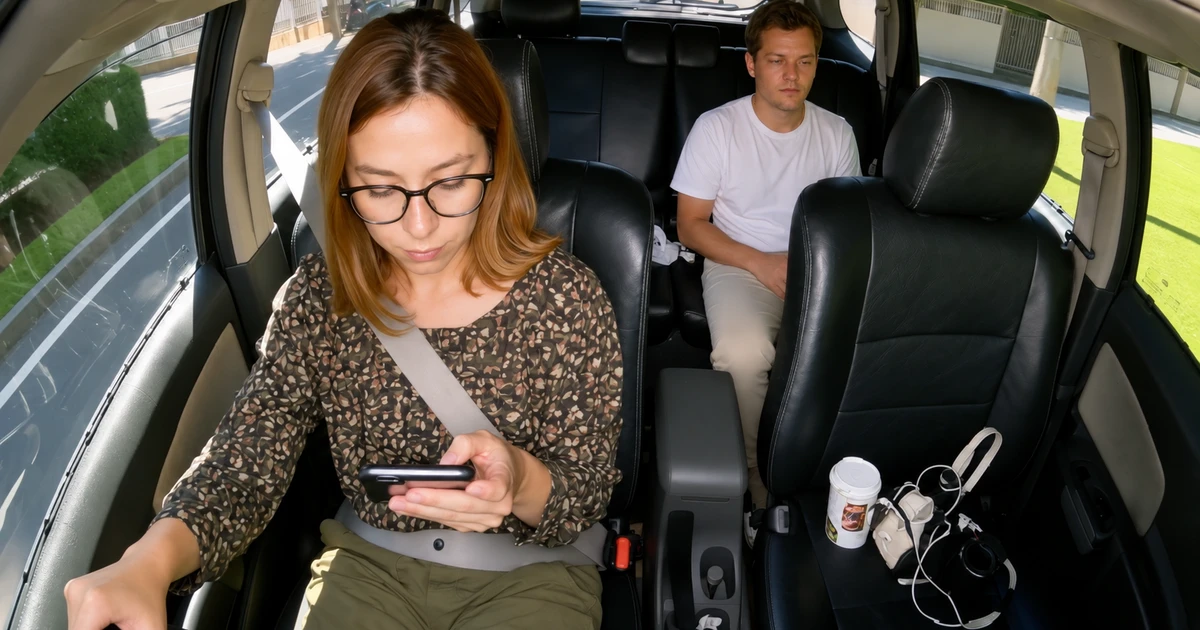
映像イベントのデータセットでは、ラベルから元の映像に戻り、映像だけでどこまで判断できるかを確認できることが大切です。「異常行動」と判定するには、時間区間、観察できる対象、行動の定義、不確実性の記録が必要です。個人情報を含む映像では、処理目的と閲覧範囲も限定します。以下は要件定義と試作検収のための提案です。
1. 都市映像AIの事例から考えるイベントの証拠
NVIDIAは2026年11月2日、既設カメラの映像を移動支援、安全確保、事案対応に活用する都市向け映像分析とサービスエージェントを紹介しました。これは提供企業の報告であり、独立評価の結果や車内監視の性能を示すものではありません。
NVIDIAによる都市向けPhysical AI・エージェントAIの紹介(英語)
出力が「車が映っている」から「対応が必要な事案が発生した」に変わると、ラベルが後続の判断に影響します。要約だけでは、どのフレームが根拠なのか、どこからが推測なのかを確認できません。都市と車内では行動の定義が異なりますが、発生時刻、ラベルを支える映像、欠けている情報を記録する点は共通です。
2. 観察事実、ルールによる判定、判定不能を分ける
手がセンターコンソールに近づいても、空調を操作したとは限りません。うつむいただけで疲労とも判断できません。物体が隠れているときは「物体を確認できない」という状態を設けます。
- 観察事実:対象の位置、見える動作、物体、遮蔽を記録し、意図や感情の推測を避けます。
- 時間の根拠:クリップID、開始・終了時刻、主要フレームの参照先を記録します。
- ルールによる判定:ルールの版と成立条件を記録します。
- 不確実性:遮蔽、根拠の矛盾、クリップの欠落を区別します。
- レビュー履歴:争点、判定、変更理由を残します。
判定不能は証拠が十分かどうかを示します。モデルの信頼度はモデル自身の出力に対するスコアです。両者は別項目で管理します。複数視点のラベルを統合する前に、各カメラが同一の時間区間を撮影しているかを確認します。
3. 手を伸ばす場面で納品する情報
説明用の8秒間の映像を考えます。前席の人物が2秒目に腕を動かし、3〜4秒目はステアリングで手が隠れ、5秒目に腕が元の位置へ戻ります。動作と遮蔽区間は記録できますが、物体を取れたかどうかは確認できません。8秒は例示のための長さです。
イベント記録と、それに紐づく可視性の区間を納品します。匿名化したクリップID、クリップ内の追跡ID、イベント種別、開始・終了時刻、ルールの版、レビュー状態を記録します。遮蔽の時間と物体を特定できない理由も残します。必要性を評価せずに、タスク内の追跡IDをカメラや撮影セッションをまたぐ個人識別に拡張しないようにします。
物を取った結果が必要な場合は、判定不能に分類するか追加撮影します。動作開始の基準も、腕の動き始め、空間境界の通過、物体との接触などから明示し、学習と評価で同じ版を使います。
4. 要約から原映像まで確認できるようにする
要約からイベント記録へ、さらに権限のあるクリップやフレームへたどれるようにします。エクスポート時には参照先を検証し、映像の削除後もラベルだけが学習に残る事態を防ぎます。原映像、作業用コピー、納品クリップを分け、技術レビュー担当者には必要な証拠だけを、集計担当者には集計結果だけを提供します。匿名IDの適用範囲と失効条件も決めます。
ぼかしや切り抜きの後は、タスクに使えるかを再確認します。顔のぼかしで視線の証拠が失われたり、手の切り抜きで物体を取ったか判断できなくなったりします。匿名化処理とタスクが両立しない場合は記録し、撮影方法や利用許諾を見直します。収集、再利用、納品の権限はプロジェクト責任者と関係するコンプライアンス担当者が確認します。
5. 試作検収には判断しにくい映像も含める
遮蔽、途中で終わる動作、イベントの途中から始まる映像、似た物体が同時に映る映像を含めます。件数と合格基準はタスクのリスク、予算、クラス分布に応じて決めます。
- クリップとフレームの参照先、版、閲覧権限を確認します。
- モデルの回答を見せる前に、境界事例を独立に再判定します。
- 判定不能が根拠不足を表し、出力や学習で負例に置き換わっていないかを確認します。
- イベント単位とクリップ単位の結果を分け、隣接する区間の重複を確認します。
- 訂正と削除を試行し、索引と納品マニフェストの更新を確認します。
同じ人物、同じ連続撮影の隣接クリップが学習セットと評価セットの両方に入らないようにします。
6. 調達要件に判断の範囲を書く
使用するカメラと時間範囲、出力が観察できる動作・ルールで定義したイベント・自然言語の要約のどれか、証拠不足時に返す状態を決めます。そのうえで収集範囲、ラベル項目、アクセス権限、検収方法を定義します。手がセンターコンソールに近づく映像を探すだけなら心理状態の推定は不要です。物体を取った結果まで求めるなら、それを観察できる撮影条件が必要です。