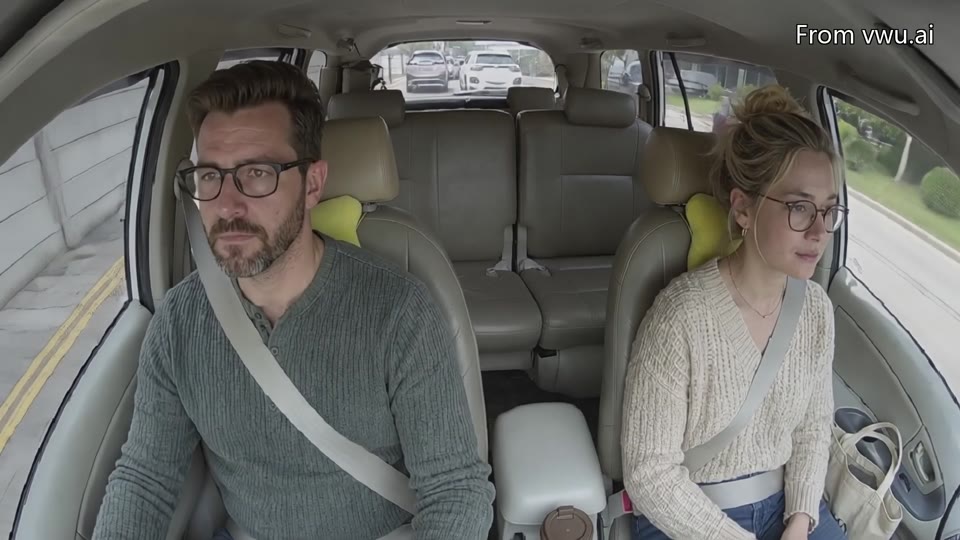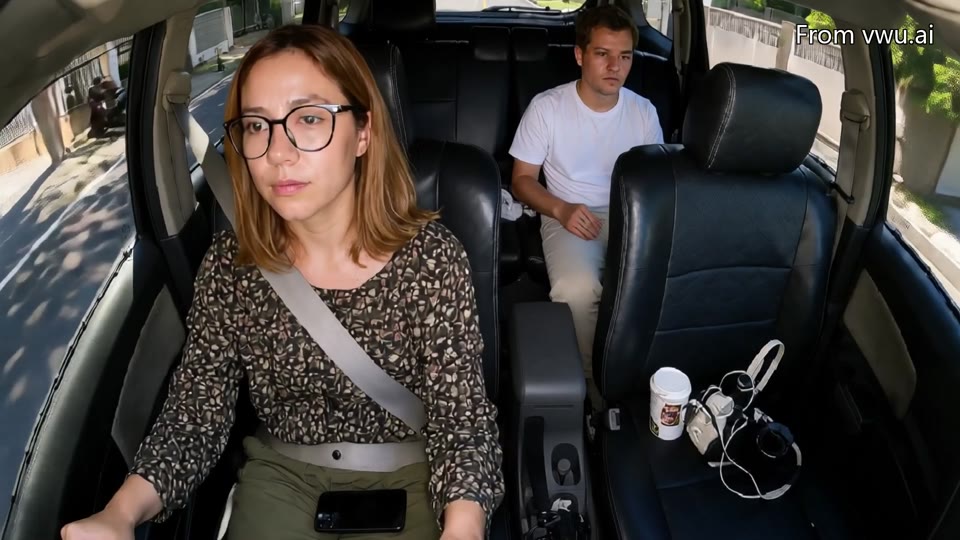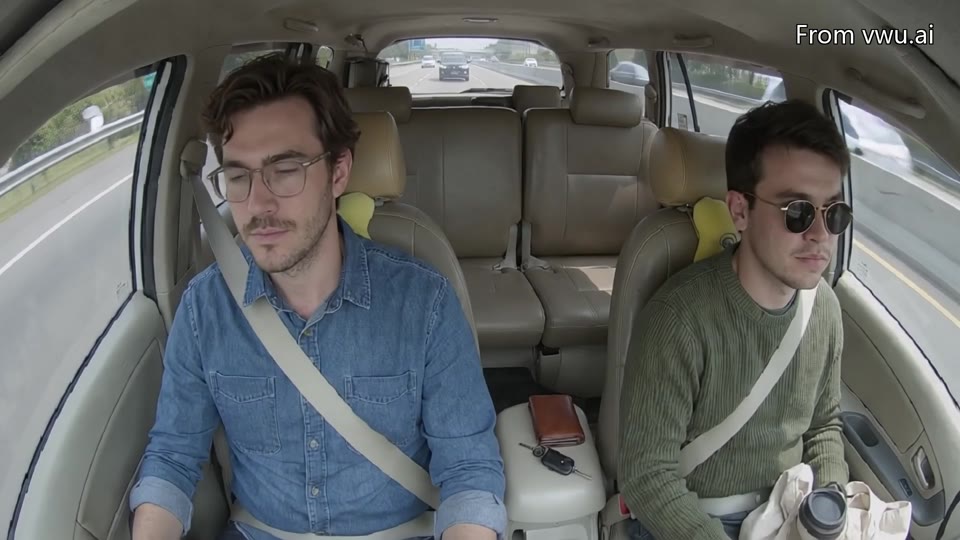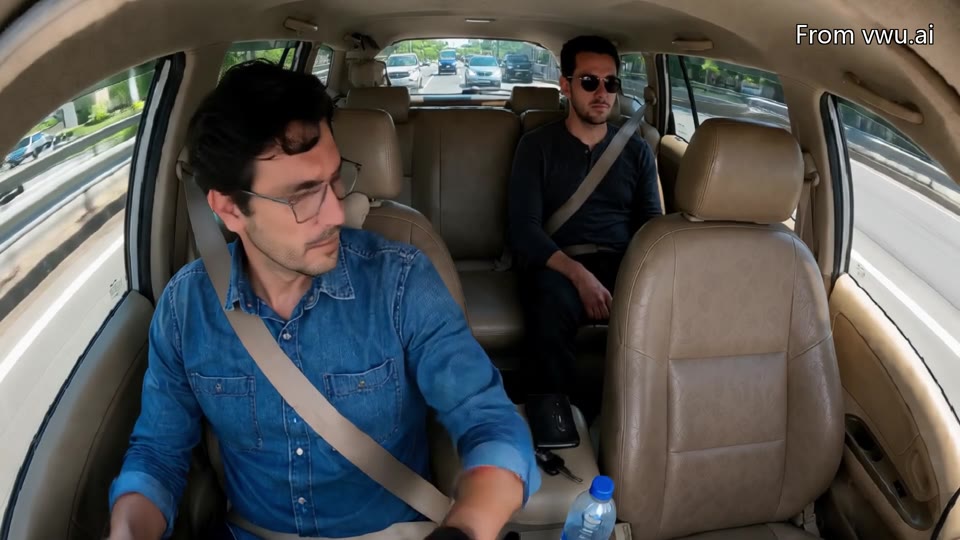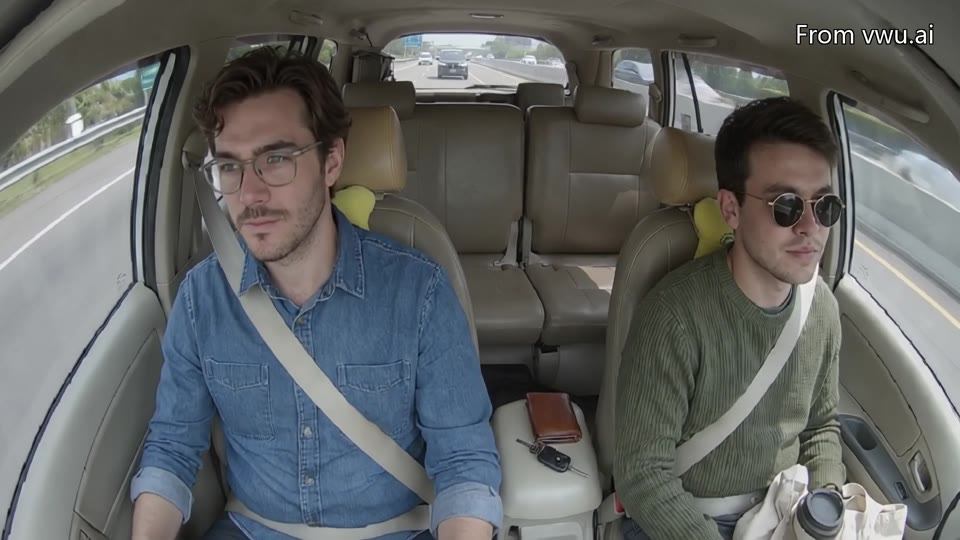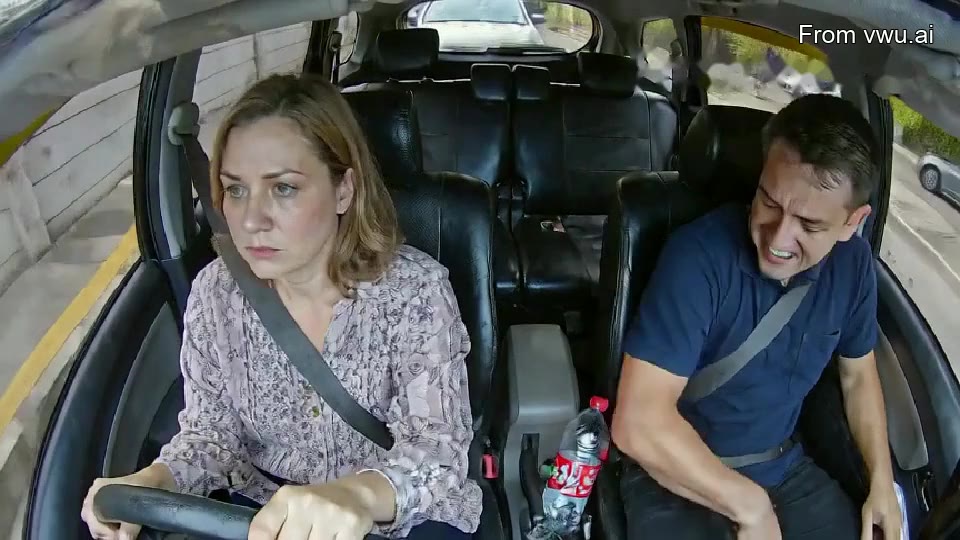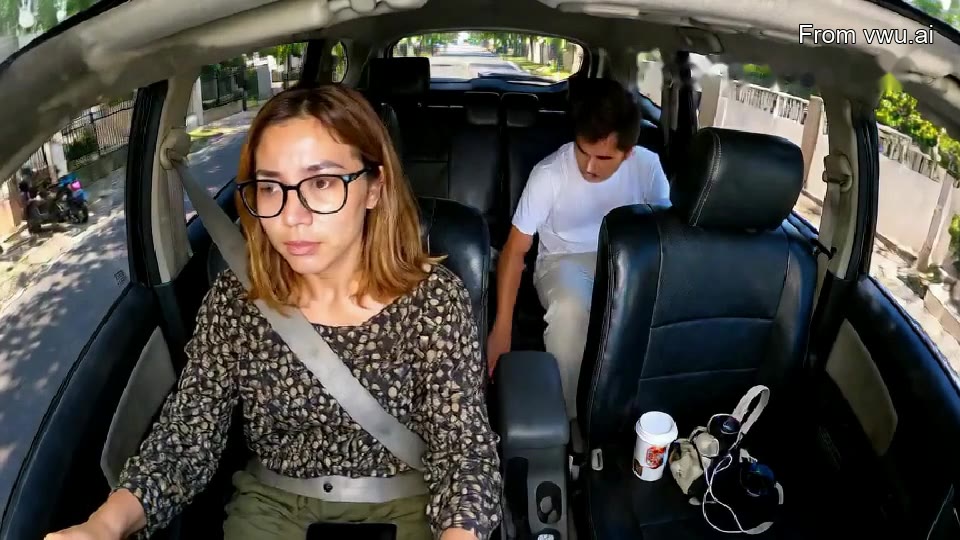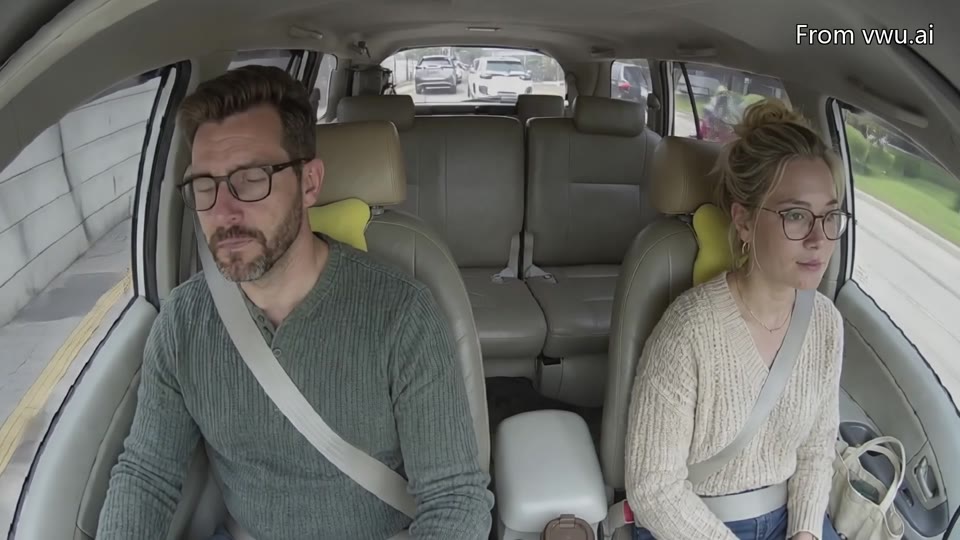
认知分心行为
根据可见动作定义标签;示例名称不等于对注意力状态的测量。
来源为 VWU.AI 官网现有演示视频,本页复用同一文件。以下说明仅帮助确定样本需求,未将展示标题当作已经审核的标签。
把视频中的可观察证据与项目目标连接起来,避免只凭画面观感决定是否批量采购。
指出目标人物和动作发生区间。记录动作是否完整、是否需要上下文以及相似行为为何不属于该类。
检查人数、座位、视角、光照和遮挡。公开示例只展示部分条件,其他条件需要单独提出并通过样本确认。
明确类别、时间单位、对象编号、坐标规则及未知情况。若视频本身不足以证明某个标签,应保留不确定性。
先用项目样本检查文件、标签和元数据能否导入你的流程。公开演示视频不是包含完整授权与标注的数据集交付。
本页展示的是公开演示,未公开任何新增客户信息或客户训练结果。
| 材料类型 | 能说明什么 | 还需要确认什么 |
|---|---|---|
| 公开演示 | 可用于讨论的场景与可见行为 | 项目目标、规格和标签是否能满足 |
| 项目样本 | 是否符合约定的样本与审核规则 | 批量条件、数量和交付范围 |
| 真实客户案例 | 经授权且可核实的项目过程与结果 | 客户许可、披露范围和证据材料 |
选择一个最接近目标的示例,说明需要保留哪些条件以及哪些地方需要变化。
例如需要不同视角、人物角色或更明确的动作时间边界。避免只写“类似但更多”,这样无法判断样本是否通过。
说明什么表现算成功、什么情况需要返修,以及负例需要保留什么特征。若已有规则,请提供不含机密信息的版本。
填写训练或评估用途、数量、视频规格、标签字段和时间表。数据使用权、样本安排和交付范围再按项目确认。
把样本反馈记录到场景和规则版本中。只有已确认的范围进入批量生产,新条件需要相应验证。
提供任务、场景、视频与标注要求以及目标时间表,先讨论可验证的项目样本。