认知分心行为
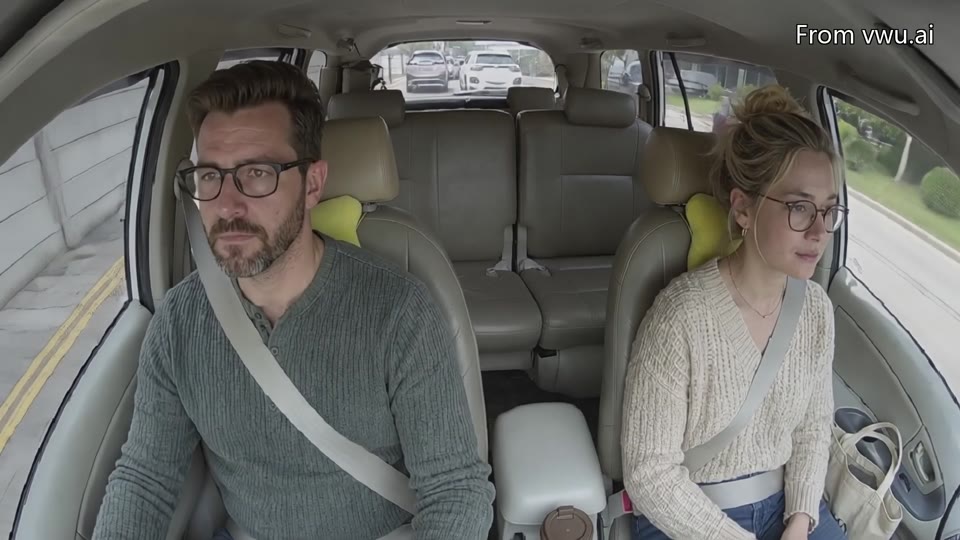
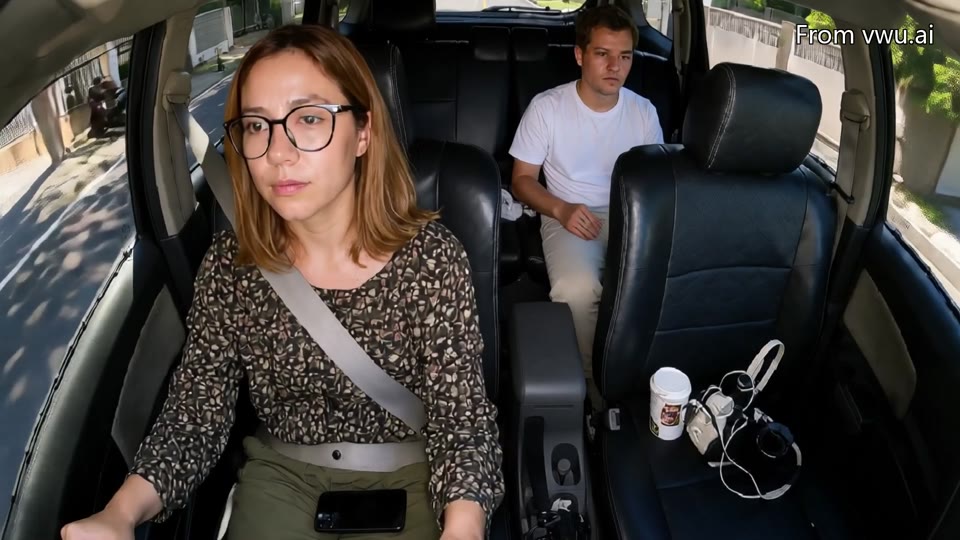
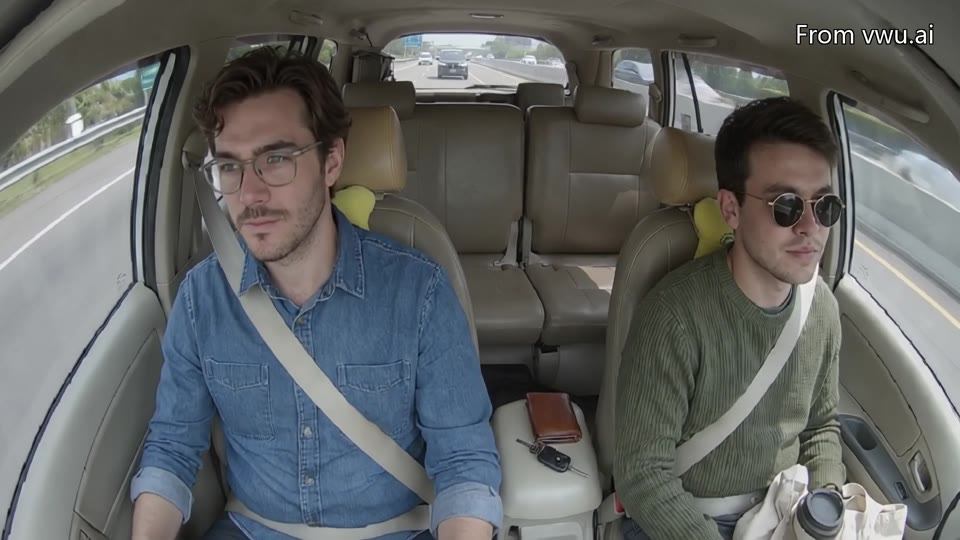
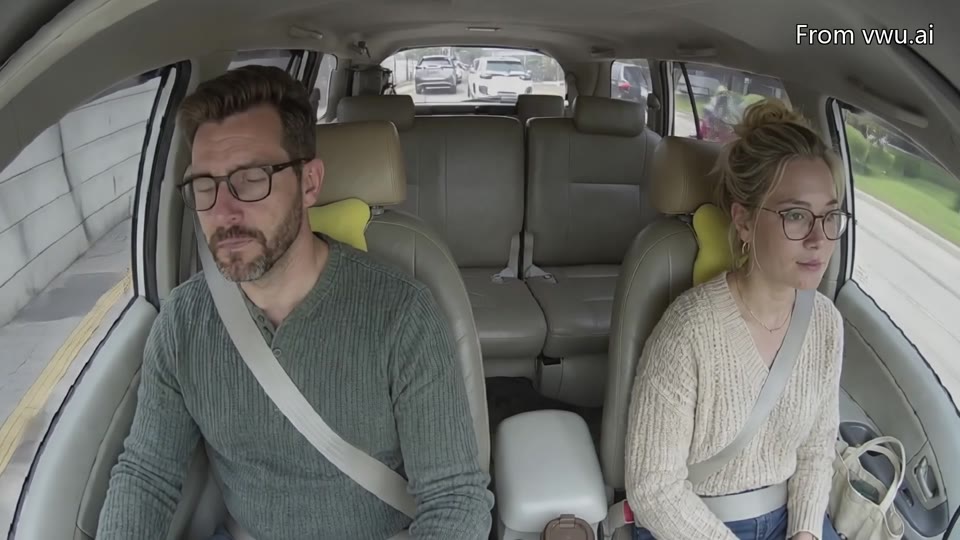
用于讨论分心行为定义的已公开车内视频。
先沟通目标行为与样例要求,再确认生产范围、标注格式和验收标准。
需求沟通 → 样例确认 → 生产与交付
chan@vwu.ai原创合成概念场景,用于演示交互;不代表模型识别结果。
生产前明确行为分类、正负样本与验收标准,并在样本阶段确认场景可行性与质量。
明确需要呈现的疲劳动作、细微迹象及持续时间,约定正样本、轻微迹象与正常行为的分类边界。
描述模型需要识别的行为,例如视线偏移、回头或寻找物品,同时确定场景上下文、动作边界和标签。
指定手机使用动作、摄像机视角与场景变化,使批量视频和标注中的行为定义保持一致。
定义乘客与司机的互动及罕见安全场景,在样本阶段核对人物、座位、动作与时序,再决定批量生产。
将场景、视频规格与标注需求一起定义,选择与模型部署相关的变量,再验证有代表性的组合。
先确认交付物与质检要求,再推进批量生产;数量、排期和标注范围按具体项目确认。
提供目标行为、车内环境、摄像机视角、视频时长、数量和标注要求,并说明计划如何评估数据。
批量生产前检查样本,确认场景准确性、画面质量、标签及数据目录结构。
按约定场景生产,检查内容、画面与重复情况,并完成项目确定的标注工作。
交付约定的视频、标注和元数据。对于已验证场景,可进一步讨论人物、环境和动作变量的扩展。
生产前,可参考驾驶员与乘员监控训练数据采购验收清单,明确行为标签、元数据和评估集划分。
先把可观察行为和交付规则写清楚,再确定数量。以下字段供需求讨论,具体范围按样本验证结果确认。
先定义分辨率、每段时长、帧率、宽高比、视角及光照。数量与排期以样本验证后确认的项目范围为准。
定义疲劳线索、视线偏移、手机动作与乘员互动的开始、结束和重叠规则;正常动作与不确定片段单独标记。
示例字段:clip_id, actor_role, behavior, start_ms, end_ms, visibility, review_status。这些是需求设计示例,并非已交付客户数据。
项目约定视频、标签、元数据及版本说明。按人物、场景或生成配置分组划分评估集,避免相似片段混入训练和测试两侧。
把通过条件、退回原因和复验方式写进项目约定,保留可追溯的审核记录。
挑选常见、边界和容易混淆的场景一起审核,例如正常眨眼与持续闭眼、看后视镜与长时间偏离视线。
复核遮挡、动作是否在画面内、开始结束边界与标签一致性;标出无法判断的片段,不强行给正负标签。
核对文件能否播放、时长与帧率、重复片段、标签对应关系和目录清单;记录退回、修改与复验结果。
合成视频可补充场景覆盖,不能代替真实部署环境的验证,也不直接证明驾驶员的生理状态或模型精度提升。
通过官网现有需求表单提交场景清单与交付要求。
本服务按模型训练需求定制生产数据。公开视频用于讨论样本方向,最终场景范围与交付物按具体项目约定。
请描述所需人物、动作、座位与摄像机视角。我们先评估需求并验证样本,再确认是否进入批量生产。
官网服务范围包括行为标签、时间段标注、视频描述、边界框与关键点。请提供所需字段、分辨率、时长及文件结构,以便确认实际标注范围和交付格式。
在样本阶段约定场景准确性、视频质量及标注检查标准,再由你的模型或审核流程验证后决定是否扩量;不承诺模型准确率提升幅度。
通过需求表单提交场景清单、数量、视频规格、标注需求与目标排期。样本安排、价格、时间和数据使用条款按项目确认。
提供现有数据集缺失的行为场景,先讨论生产方案与样本验证,再决定批量生产。